Je mehr ich mich mit generativer KI und insbesondere mit Microsoft Foundry beschäftige, desto häufiger stoße ich auf eine Frage, die in vielen Projekten erstaunlich wenig Beachtung findet:
Was passiert eigentlich mit meinen Prompts und den Antworten des Modells, nachdem ich sie an Microsoft geschickt habe?
Die erste Antwort, die man darauf häufig bekommt, lautet: „Microsoft verwendet die Daten nicht zum Training der Modelle.”
Das ist grundsätzlich richtig. Aber es beantwortet eine andere Frage.
Denn „nicht zum Training verwendet“ bedeutet nicht automatisch, dass die Daten unter keinen Umständen gespeichert oder von Menschen eingesehen werden können. Genau an dieser Stelle wird es interessant, insbesondere dann, wenn wir nicht über irgendwelche Testprompts sprechen, sondern über echte Unternehmensdaten.
Stellen wir uns beispielsweise eine Kanzlei vor, die generative KI einsetzen möchte. Ein Anwalt möchte einen Vertrag analysieren lassen, eine Klageschrift zusammenfassen oder bestimmte Passagen aus mehreren Dokumenten miteinander vergleichen. In diesen Dokumenten stehen möglicherweise Namen, Adressen, Vertragswerte, Geschäftsgeheimnisse oder Informationen zu laufenden Verfahren.
Technisch ist das für ein modernes LLM überhaupt kein Problem.
Die spannende Frage lautet vielmehr: Was passiert mit diesen Daten auf dem Weg durch den KI-Dienst?
Abuse Monitoring – warum Microsoft überhaupt Daten prüft
Microsoft betreibt bei den über Azure bereitgestellten Foundry-Modellen ein sogenanntes Abuse Monitoring. Der Hintergrund ist nachvollziehbar: Ein Dienst, über den Millionen von Anfragen an KI-Modelle geschickt werden können, muss erkennen können, ob diese Modelle missbraucht werden.
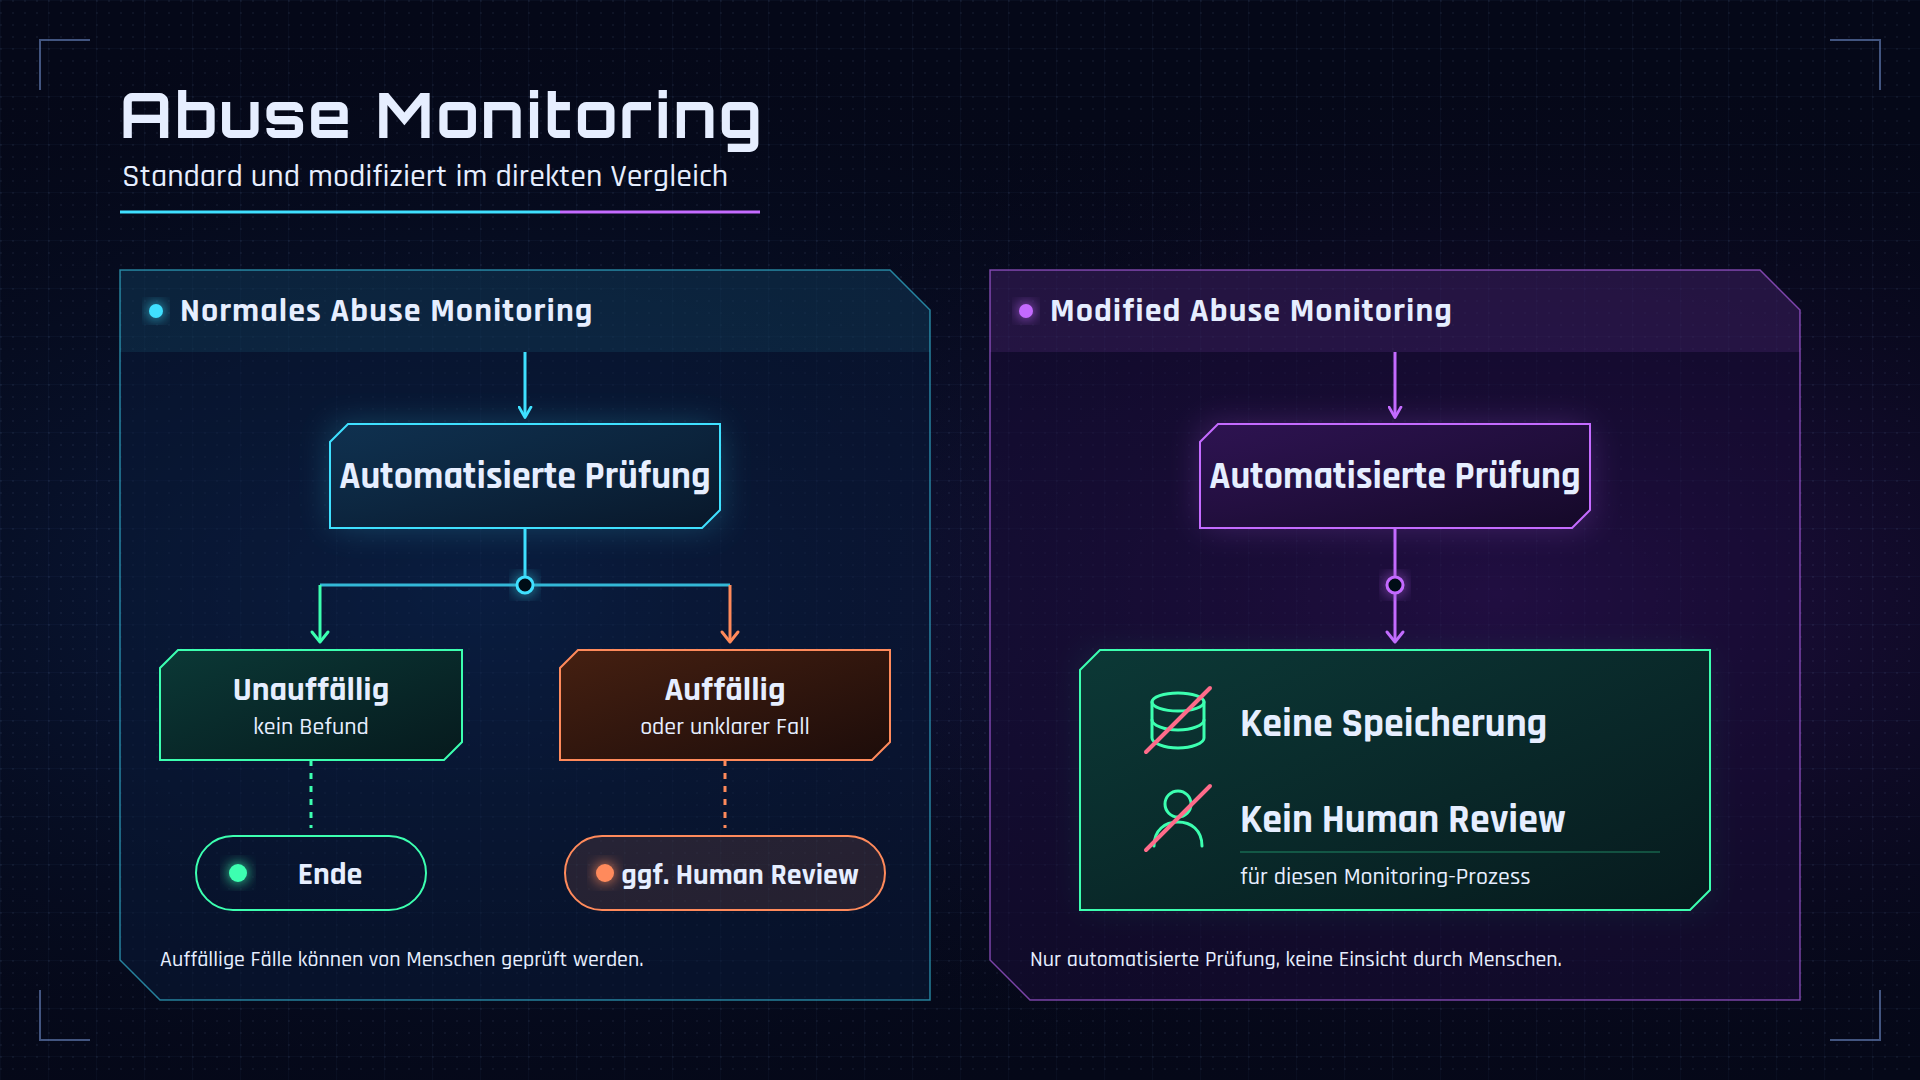
Dabei können automatisierte Systeme Prompts und Antworten analysieren und beispielsweise auffällige oder wiederkehrende Missbrauchsmuster erkennen. Wenn eine automatisierte Prüfung nicht eindeutig genug ist oder bestimmte Fälle eine weitere Untersuchung erfordern, kann unter den normalen Bedingungen auch eine menschliche Überprüfung stattfinden.
Und genau bei diesem Punkt wurde ich hellhörig.
Denn natürlich ist es etwas anderes, ob ein automatisiertes System einen Text auf bestimmte Muster untersucht oder ob ein Mensch den tatsächlichen Inhalt eines Prompts und die darauf folgende Antwort sehen kann.
Microsoft beschreibt deshalb ausdrücklich, dass unter den normalen Bedingungen Daten für das Abuse Monitoring temporär gespeichert werden können und autorisierte Microsoft-Mitarbeiter in bestimmten Fällen Zugriff auf Inhalte erhalten können, die durch die automatisierten Systeme entsprechend gekennzeichnet wurden.
Für viele klassische KI-Anwendungen mag das überhaupt kein Problem sein.
Für manche Unternehmensanwendungen ist es aber eine ziemlich wichtige Information.
Und dann kommt Modified Abuse Monitoring ins Spiel
Genau hierfür gibt es bei Microsoft Modified Abuse Monitoring.
Der Name klingt zunächst etwas kompliziert. Im Grunde geht es aber um eine ziemlich einfache Fragestellung:
Kann ich einen Azure-basierten KI-Dienst nutzen, ohne dass die für das Abuse Monitoring vorgesehenen Daten gespeichert und anschließend von Menschen überprüft werden?
Mit einem von Microsoft genehmigten Modified Abuse Monitoring wird genau dieser Prozess verändert. Die für das menschliche Abuse Monitoring vorgesehene Speicherung und menschliche Überprüfung findet dann nicht statt.
Das bedeutet allerdings ausdrücklich nicht, dass Microsoft einfach sämtliche Sicherheitsmechanismen abschaltet.
Die automatisierte Prüfung kann weiterhin stattfinden. Microsoft kann also weiterhin automatisierte Systeme einsetzen, um Missbrauch zu erkennen und beispielsweise bei schwerwiegendem oder wiederkehrendem Missbrauch Maßnahmen zu ergreifen.
Das ist ein wichtiger Unterschied.
Man sollte Modified Abuse Monitoring daher nicht als „Abuse Monitoring aus“ verstehen, sondern eher als eine Änderung daran, wie Microsoft das Abuse Monitoring bei bestimmten Kunden technisch und organisatorisch durchführt.
Vereinfacht sieht der Unterschied ungefähr so aus:
Und genau diese Unterscheidung finde ich in der Praxis sehr wichtig.
Aber ist das einfach ein Schalter im Azure Portal?
Nein.
Das ist wahrscheinlich einer der Punkte, die bei diesem Thema am häufigsten falsch verstanden werden.
Modified Abuse Monitoring ist keine Einstellung, bei der ich in meinem Azure Portal irgendwo einen Haken entferne und anschließend ist das Thema erledigt.
Microsoft behandelt Modified Abuse Monitoring als Limited-Access-Funktion. Dafür ist eine entsprechende Genehmigung erforderlich. Microsoft beschreibt, dass solche erweiterten Optionen nur für bestimmte Kunden beziehungsweise Partner zur Verfügung stehen, beispielsweise wenn eine entsprechende Betreuung durch ein Microsoft Account Team oder ein dafür vorgesehenes Programm besteht.
Das heißt auch: Nur weil ich einen besonders sensiblen Anwendungsfall habe, kann ich nicht einfach davon ausgehen, dass Modified Abuse Monitoring automatisch aktiviert wird.
Ich muss das Thema mit Microsoft klären und die entsprechenden Voraussetzungen erfüllen.
Modified Abuse Monitoring ist nicht dasselbe wie Zero Data Retention
Hier wird es noch einmal interessant, denn rund um Azure OpenAI und Microsoft Foundry werden verschiedene Begriffe gerne miteinander vermischt.
Modified Abuse Monitoring und Zero Data Retention sind nicht einfach zwei verschiedene Namen für dasselbe.
Modified Abuse Monitoring beschreibt konkret das Verhalten rund um das Abuse Monitoring, insbesondere die Speicherung und mögliche menschliche Überprüfung im Rahmen dieses Prozesses.
Das bedeutet aber nicht automatisch, dass meine gesamte Anwendung keinerlei Daten mehr speichert.
Wenn meine Anwendung beispielsweise zusätzlich Application Insights, Log Analytics, eine Datenbank, Storage oder eigene Conversation Logs verwendet, gelten dafür weiterhin deren jeweilige Speicher- und Löschregeln.
Das ist bei einer Architekturprüfung ein entscheidender Punkt.
Ich kann also nicht einfach sagen:
„Wir haben Modified Abuse Monitoring, deshalb werden nirgendwo mehr Daten gespeichert.“
Das wäre falsch.
Die eigentliche Frage muss vielmehr lauten:
Wo werden meine Daten innerhalb der gesamten Anwendung verarbeitet und gespeichert?
Und was ist mit Content Filtering?
Auch das sollte man voneinander trennen.
Content Filtering beziehungsweise Guardrails beschäftigen sich damit, welche Inhalte ein Modell verarbeiten oder zurückgeben darf und wie problematische Inhalte behandelt werden.
Modified Abuse Monitoring beschäftigt sich dagegen mit dem Missbrauchsschutz des Dienstes und insbesondere der Frage, wie dieser Abuse-Monitoring-Prozess mit Daten und menschlicher Überprüfung umgeht.
Das sind zwei völlig unterschiedliche Ebenen.
Ich kann also beispielsweise strenge Content-Filter verwenden und gleichzeitig das Thema Modified Abuse Monitoring separat betrachten.
Warum das für SaaS-Anbieter besonders interessant ist
Für einen privaten Entwickler ist diese Frage vielleicht zunächst weniger relevant.
Für einen SaaS-Anbieter sieht die Situation aber völlig anders aus.
Sobald meine Anwendung Daten von Kunden verarbeitet, muss ich mir irgendwann die Frage stellen, welche Daten ich an welchen Dienst weiterreiche und welche Verarbeitungsprozesse dort stattfinden.
Das betrifft beispielsweise:
- Kanzleien und Legal-Tech-Anwendungen
- Banken und Versicherungen
- Gesundheits- und Sozialwesen
- Unternehmensberatung
- HR-Anwendungen
- interne Unternehmens-KI
- SaaS-Produkte mit vertraulichen Kundendaten
Gerade bei solchen Szenarien reicht es deshalb meiner Meinung nach nicht mehr aus, einfach nur zu fragen:
„Wo läuft das LLM?“
Die viel wichtigere Frage lautet:
„Was passiert mit meinen Daten während der gesamten Verarbeitung?“
Und genau deshalb finde ich Modified Abuse Monitoring so interessant.
Es ist kein spektakuläres KI-Feature. Kein neues Modell. Keine höhere Token-Geschwindigkeit.
Aber es kann bei der Entscheidung darüber, ob ein bestimmtes KI-Modell überhaupt für einen sensiblen Anwendungsfall eingesetzt werden darf, eine entscheidende Rolle spielen.
Mein persönlicher Blick darauf
Ich glaube, dass wir bei generativer KI gerade lernen müssen, Datenschutz und KI-Sicherheit etwas differenzierter zu betrachten.
In den ersten Jahren der Cloud war die Frage häufig: „Wo liegen meine Daten?“
Bei generativer KI reicht das inzwischen nicht mehr.
Wir müssen zusätzlich fragen:
Was wird mit meinen Daten verarbeitet? Welche automatisierten Prüfungen finden statt? Können Menschen Inhalte sehen? Wie lange werden Informationen gespeichert? Welche Daten speichert meine eigene Anwendung zusätzlich? Und welche Möglichkeiten habe ich, diese Prozesse vertraglich und technisch zu beeinflussen?
Modified Abuse Monitoring ist dabei nur ein Baustein.
Aber ein ziemlich wichtiger.
Denn wenn ich eine KI-Anwendung für ein Unternehmen entwickle, möchte ich am Ende nicht nur sagen können: „Die Daten werden nicht zum Training verwendet.“
Ich möchte genau wissen, welchen Weg die Daten durch meine Architektur nehmen.
Und genau deshalb würde ich Modified Abuse Monitoring heute bei sensiblen Azure-KI-Projekten nicht mehr als nebensächliches Detail betrachten, sondern als Teil der Architektur- und Datenschutzdiskussion.
Fazit
Modified Abuse Monitoring ist kein Schalter für „Microsoft sieht meine Daten nicht mehr“. Es ist eine von Microsoft genehmigte Anpassung des Abuse-Monitoring-Prozesses, bei der die dafür vorgesehene Speicherung und menschliche Überprüfung entfällt, während automatisierte Missbrauchserkennung weiterhin möglich ist.
Für mich ist aber vor allem eine andere Erkenntnis wichtig: Bei generativer KI sollten wir nicht mehr nur danach fragen, welches Modell am besten antwortet.
Wir sollten genauso fragen, unter welchen Bedingungen wir dieses Modell mit unseren Daten überhaupt einsetzen können.
Und genau an dieser Stelle wird Modified Abuse Monitoring plötzlich ziemlich interessant.